







在X站群里边经常看到有讨论域名被墙的七七八八,实际上小白对于这个问题很是疑惑与不解,更不知道怎么去解决这个事情,今天有点时间,正好写这一篇文章,专门用口语化、大白话给小白站长深度剖析下这个事情,避免去讲过于专业的技术原理。
深度剖析域名被墙的根本原理
什么是墙?简单的概括,你没有梯子,上不了Google,为什么上不了?因为有一个叫做“防火墙”的东西,这就是所谓的墙。
实际上你的网站被墙,只是在国内打不开,在国外是可以正常打开的。
知道了什么是墙,我们就继续往下深度剖析,你的网站为什么会被墙。
1、人工投诉
这种,基本上无解,别人直接把你的站投诉到国内某些平台或某些客户端点击举报按钮等,人工会给你墙掉,这种情况,神仙来了也没办法。
2、客户端传播
我们站长为了做流量,经常会在各种客户端分享我们的网址,比如微信、QQ、支付宝、抖音、搜狗输入法、UC浏览器乱七八糟的,在这些平台,第一次分享没有什么大问题,也可以打开,但是随着时间久了(一般情况,也就几天),你的域名就打不开了,接下来就是被墙。
这是为什么呢?
因为国内的客户端,基本上都有内置的过滤系统,对接了国家的安全平台,直接识别到,然后就被墙掉了。
3、搜索引擎爬虫
经常会有站长说,我买的域名,做了x站,我还没推广呢,怎么就被墙了?这大概就是被搜索引擎爬虫抓取到了页面源码,一看,你小子做x站,然后上报、被墙。
以上,就是最为常见的三种,下边我们在说说怎么解决被墙的问题。
重要的点:域名与IP
一个网站基本的形成是,你买了域名,然后A记录解析到服务器的IP上,对于被墙,域名会被墙,IP也会被墙,什么意思呢?
比如你的IP是“1”,那么域名被墙,你换一个域名,解析到“1”这个IP上就可以了,新域名就可以访问了。如果你的IP给墙以后,那么你换什么域名,你的这个网站都打不开,只能换服务器上的IP。
这就是IP和域名的关系,在看下边的内容,要提前理解下这个问题。
请熟读以上内容,在反复阅读以下内容,自行组合章节,你会豁然开朗。
被墙之 – CDN服务
CDN是一种加速的服务,我们不讲它其他的功能,我们只说它为什么能保护服务器IP不被墙,这得益于CDN本身的工作机制,可以把真实的服务器IP隐藏起来,让“墙”不容易找到你真实的IP,有人说,墙了CDN的IP怎么办呢?严格地说,CDN也会面临这个问题,但是通常CDN服务商有着海量的IP,关键词“海量”。
CDN大概的原理是,你的域名 > 解析到 > CDN/IP/域名 > CDN服务 > 转发到 > 你服务器的IP,不太严谨的可以这样理解。
被墙之 – 导航页
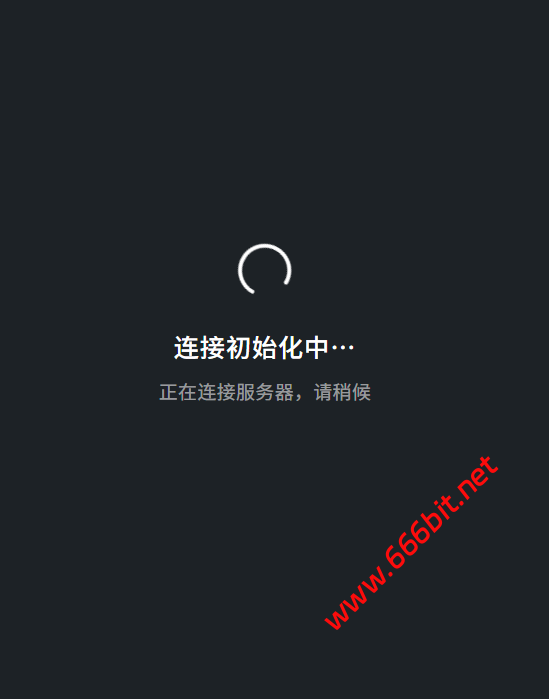
这里的导航页指的不是传统的导航,一打开网页里边有很多其他网址,这里的导航页指的是,打开以后是正常内容,给用户一个提示,类似“正在跳转中”,几秒后跳转到目标网页,这里正在“跳转中…”是内置的一个域名轮换。
通常这种也叫做网址发布页,因为看起来,页面本身没有任何违规的东西,要知道被墙的第一步,都是系统检测,骗过系统就好了,当然如果被人工举报,那就没辙。
被墙之 – 所谓的域名防红服务
各位因该听说过类似的服务,大概的原理就是跳转跳转在跳转,就是你的域名解析到对方的服务器的IP上或者别名解析到对方的网址,然后打开你的网站,他们内部会有N层跳转,每层跳转可能会有CDN服务也可能没有,也可能页面源码会转译混淆等等,这就是所谓的域名放红服务。
红,也可以不严谨的理解为墙。
被墙之 – 验证码
这是最近1-2年比较流行的,大概的逻辑就是,打开网页,需要输入验证码,输入以后,然后跳转到正常页面,不输入看不到,这种也能有效的避免被墙。
以上讲的都是基于“逻辑”,我们在来讲讲“技术”相关的逻辑。
“墙”系统怎么识别网页违规?罪魁祸首“HTML”
所有,通过浏览器打开的网页,由3种东西组成,HTML(网页内容)、CSS(网页样式)、JS(JavaScript,网页的动作,比如弹窗、自动跳转等等动作)。
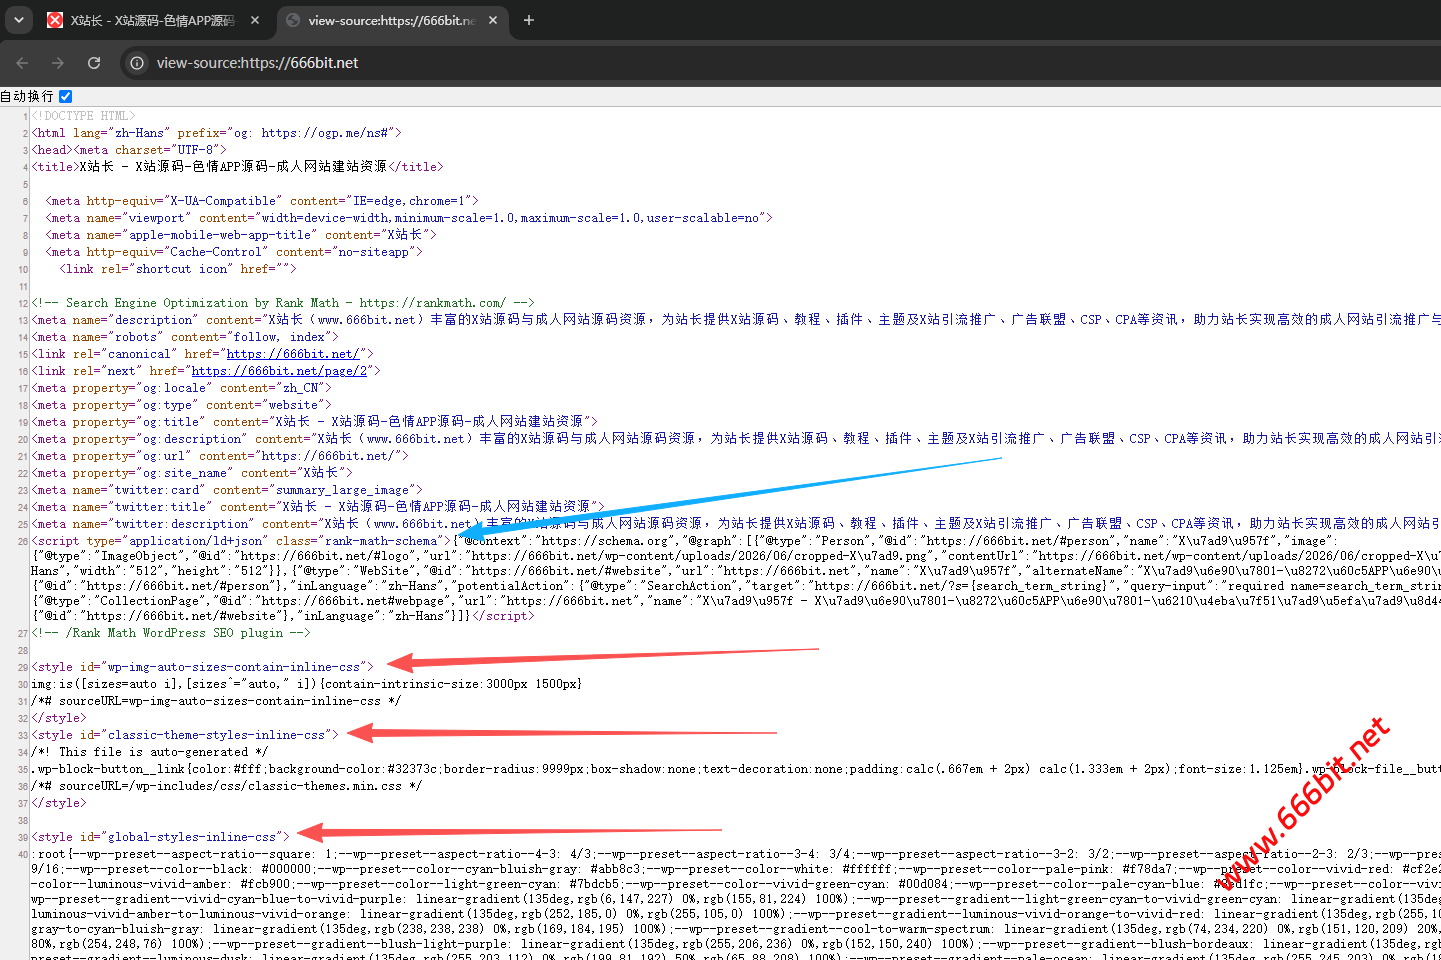
以上图片,蓝色箭头是JS,红色箭头是CSS,剩下的都是HTML。(右键,查看源文件即可看到)
CSS和JS基本上对被墙没有太大的影响,HTML是罪魁祸首。
我们上边说了很多,“墙”系统,第一层是系统自动检测,检测网页的内容,那么程序怎么识别内容?它只能从网页的源码中实现,我们看上图可以注意到,HTML代码中有很多“敏感词”,这样就会导致被墙,当然这只是最最最基础的检测方式,大概如下:
1、墙系统发现你的网站,可能是客户端内置也可能是搜索引擎爬虫等等,总之有个东西发现了你的网址。
2、访问
3、系统自动查看网页源码
4、网页格式化(这点类似搜索引擎的工作原理),就是去掉所有HTML代码,包括CSS/JS。
5、提取网页所有的文本内容。
6、对应系统内部关键词系统对提取的内容进行分词(就是“墙”系统内部,有一个巨大的敏感词,词库)
7、做出判断,是墙还是不墙。
大概就是以上的原理,如果聪明的小伙伴可能发现了一个问题,或者小脑瓜在转,既然,系统是根据页面源码中的文本内容识别,那么有没有办法“隐藏、加密”内容呢?让系统看不懂,但是现实是正常显示?
OK,你学会思考了,确实很多人在这样做,如下图:
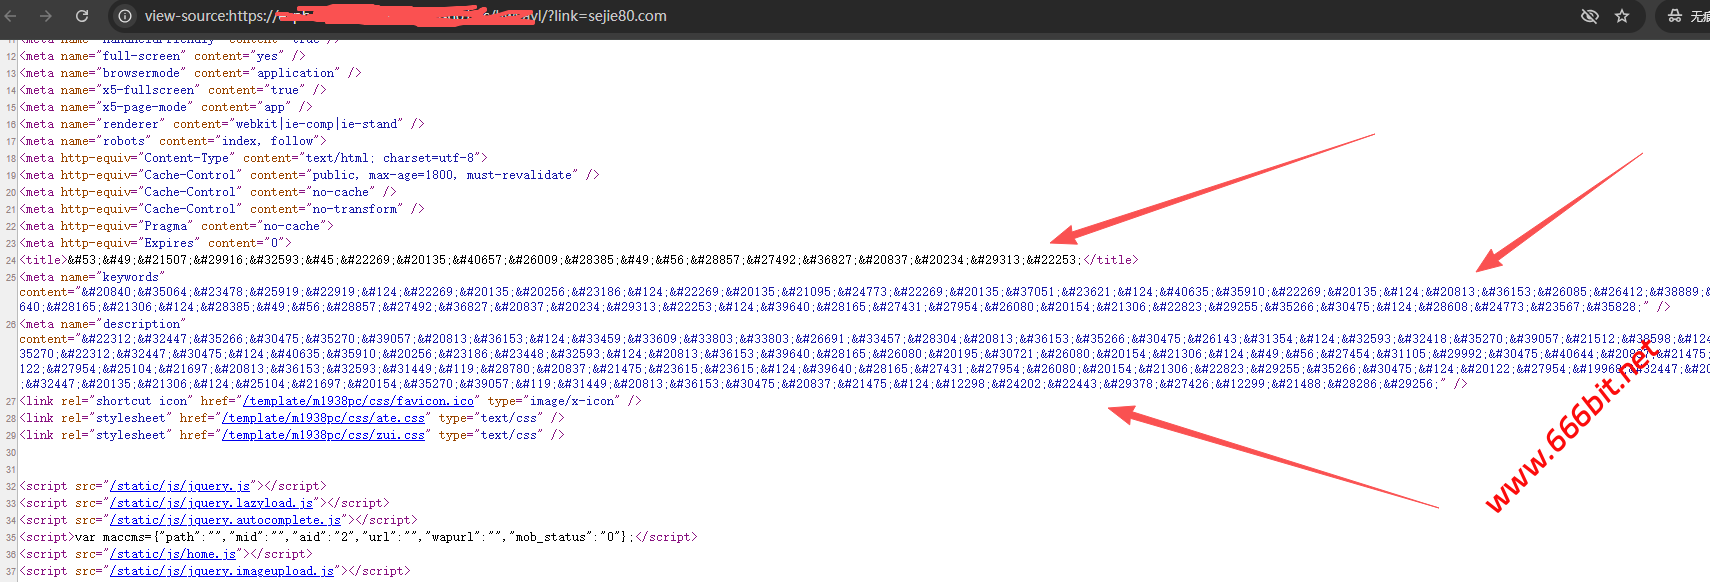
我们看上图,页面源码中一个字都没有,这是把“所有的字进行的编码”,大概你可以理解为一种编码格式(十进制),这种就是防“墙”一种手段,当然,这种其实一行代码就能还原,所以这种也不是很推荐。
前后端分离
什么是前后端分离?我们上边有说过,系统是根据网页源码的区分,上边那个图虽然对汉字进行的编码,也仅仅是让人看不懂而已罢了。接下来说的是前后端分离,用大白话,传统网页,把内容放到HTML标签中,前后端分类,把内容放到JS中,查看网页源码,真的是,一个字都没有,如下图:
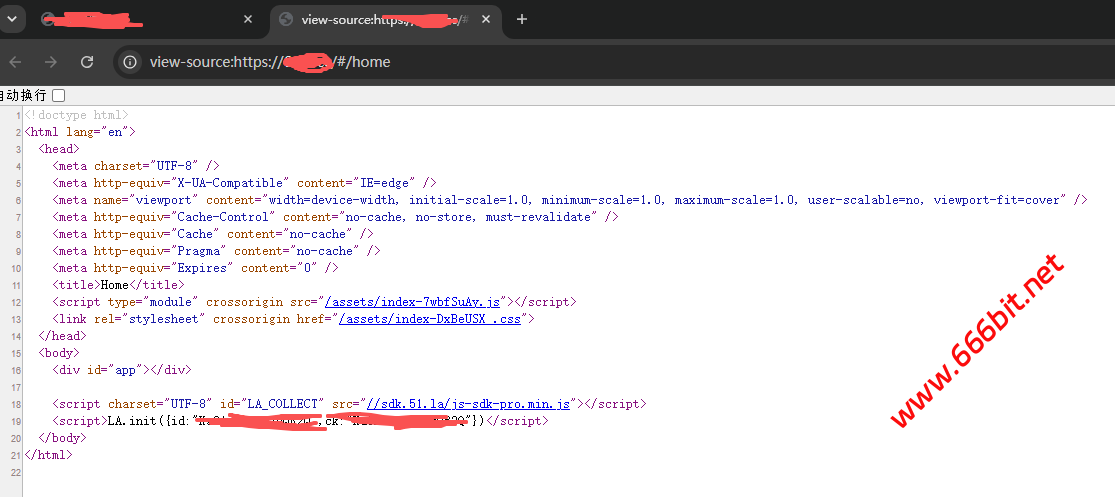
大概的原理是,打开网页 > 浏览器渲染 > JS去请求服务器上的接口 > 接口返回数据 > 数据进行内部绑定 > 显示给用户,这样的情况,“墙”系统就看不到内容了。
注意:由于前后端分离,是没有任何内容,所有内容都在接口里边,这就有个弊端,无法做SEO优化,如果要做服务端渲染,那就是技术相关的事情了,不在本文范畴。
“墙”,到底是什么?
我们可以把“墙”理解为一个程序、一个系统,在我出国之前,叫做“天网”,他是一个统称,里边有若干个模块,比如人脸识别,应用于x安、交通等,有非常多子模块,其中一个,就是负责“互联网信息的筛选、过滤、预警”,并且你知道,这个“天网”是x家级的“系统”,可以说,100%接入了国内所有的1、2、3线的客户端,这些客户端都是毫无保留的公开给这个系统,So…你仔细琢磨琢磨。
最后小记
如果你是小白,深度阅读全文,我相信,你会有收获,而且深度阅读本文以后,见到类似的网站或市面上相关的站,你一眼就可以猜出对方大概是用的什么方式做防封处理。
实际上没有任何100%防封的方法,没有一个能100%。不管怎样,你都绕不过人工介入,一旦人工介入,任何方法,都凉凉。
最后,如果你是网站:
1、建议,给用户做好提醒,或许最新访问网址的路径
2、如果你真的打算好好运营一个站,不要单独使用上边的方法,要交叉使用。
3、如果你主打国外,主要针对Google,那么就不要考虑前后端分离,老老实实做传统的HTML模板(对于标准化SEO,最近有空我会写一篇长文)。
本来我想写的更专业一点,但是考虑到给小白阅读,还是口语化一些更接地气吧。
文章作者
本文非站长所写,是由X站长群内一位爱分享的技术大佬投稿,文章中有不懂或者想交流的可以联系他的TG号: @zhiyuan1988
首发:X站长网